
2026云栖大会:AI多模态的演进
- 2026/09/27
- 0阅读
今年也是早早在网页上报了名,但是这次畅享票没有实体纪念门票卡了,不太好留念了🤣。(今年居然还整出黄牛了,小红书上刷到有黄牛带没票的观众走后门入场….)
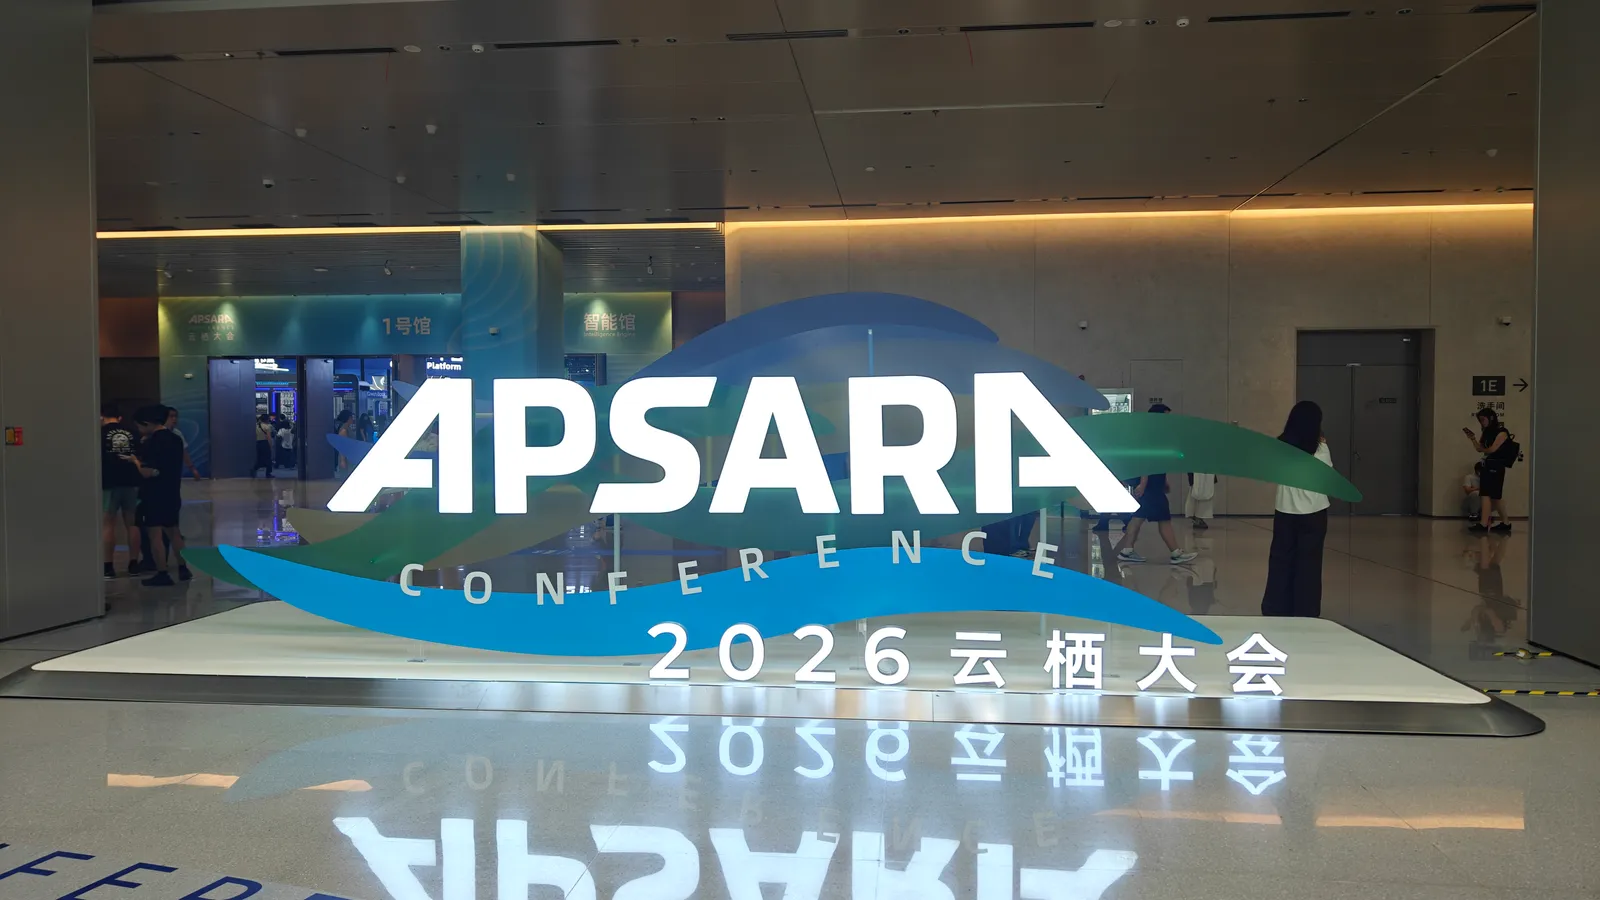
场馆从云栖小镇搬到了杭州国际博览中心,地方是大了不少,就是不方便切换会场听其他讲座了。去年技术论坛都在一块地方,出门走两步就能换场,今年每个会议都隔得有点远。(会议室场地安排也难评,有的会议室小但后排挤满了人;有的跟广场一样大又空落落的😂)
去年那份会议计划,是我在云栖官网一个个翻日程,挑感兴趣的记录,然后在Excel中仔细规划的。今年就不一样了,我直接让“千问办公”Vibe Coding了一个日程清单页面,我直接在网页里订阅感兴趣的议程,然后代码自动排列日程表和会议清单,同时标记时间重叠的场次。这样我可以根据现场时间,灵活就近选择相应议程去听。
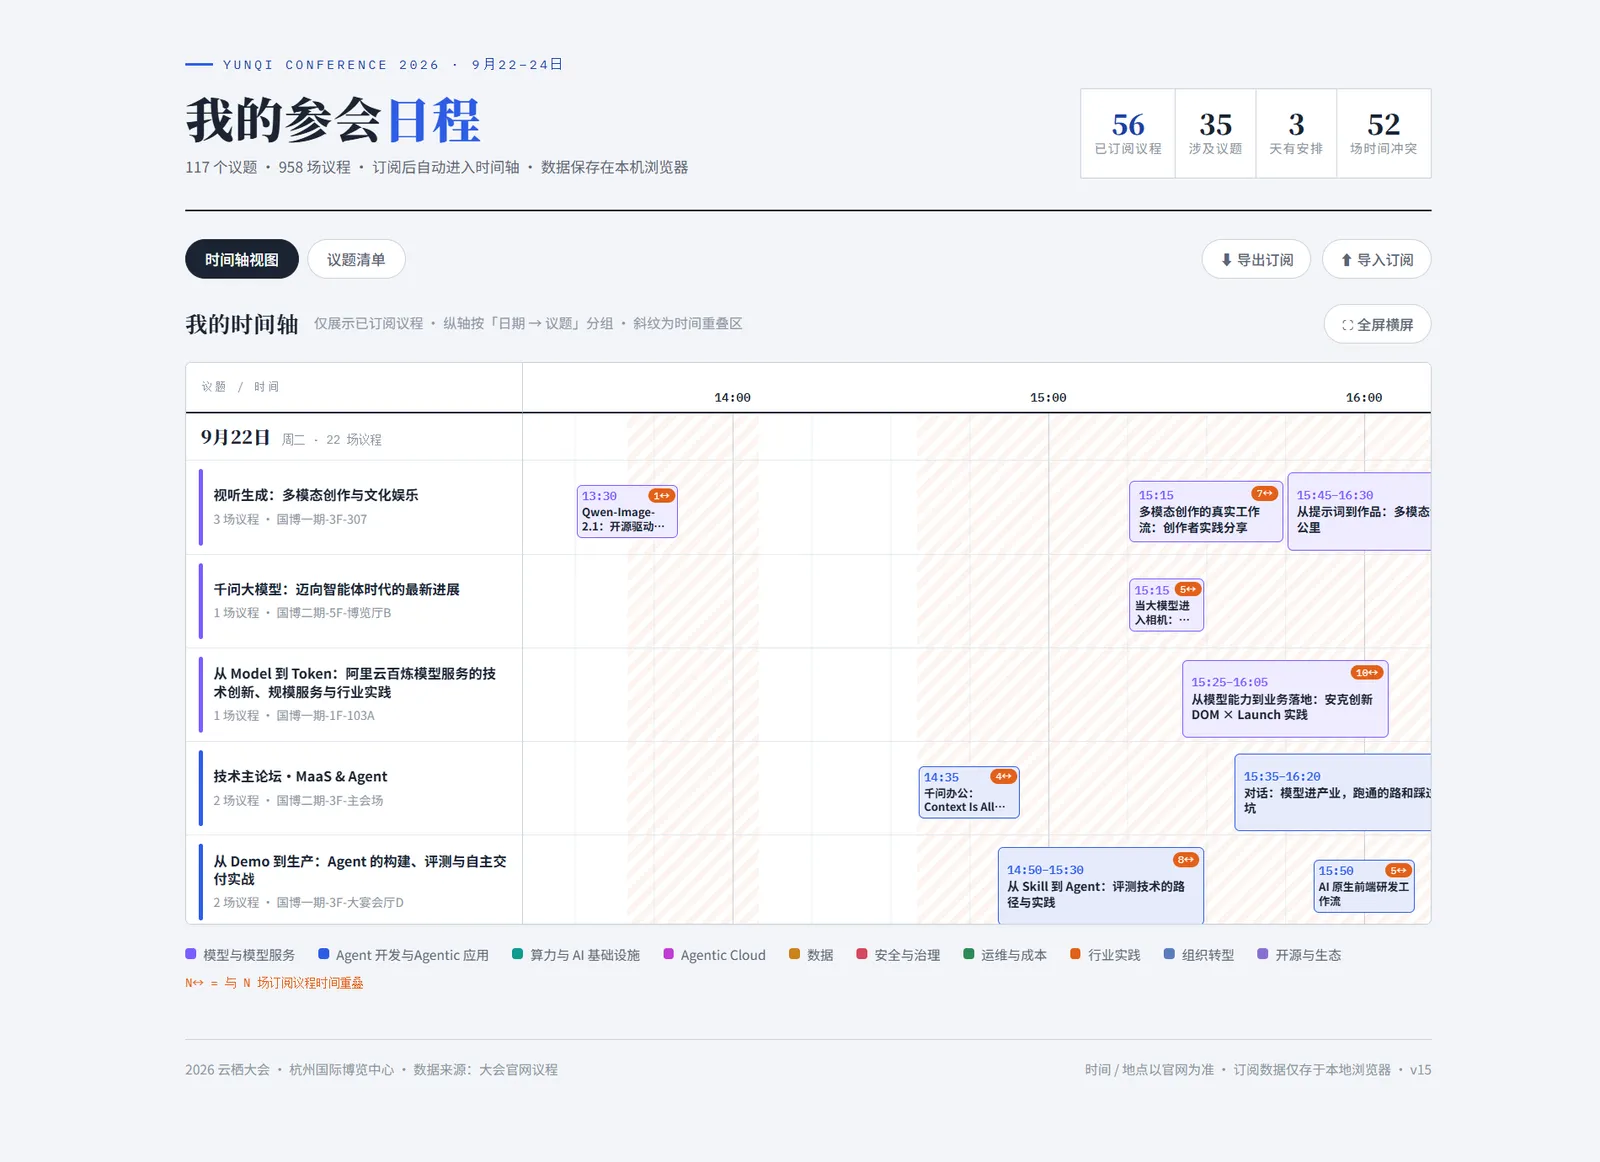
等大会开始了之后才发现有些议题不开放线上直播,但官网的日程中也没有列出来。导致想线上听的听不上,想到场听的站不下😂
第一天
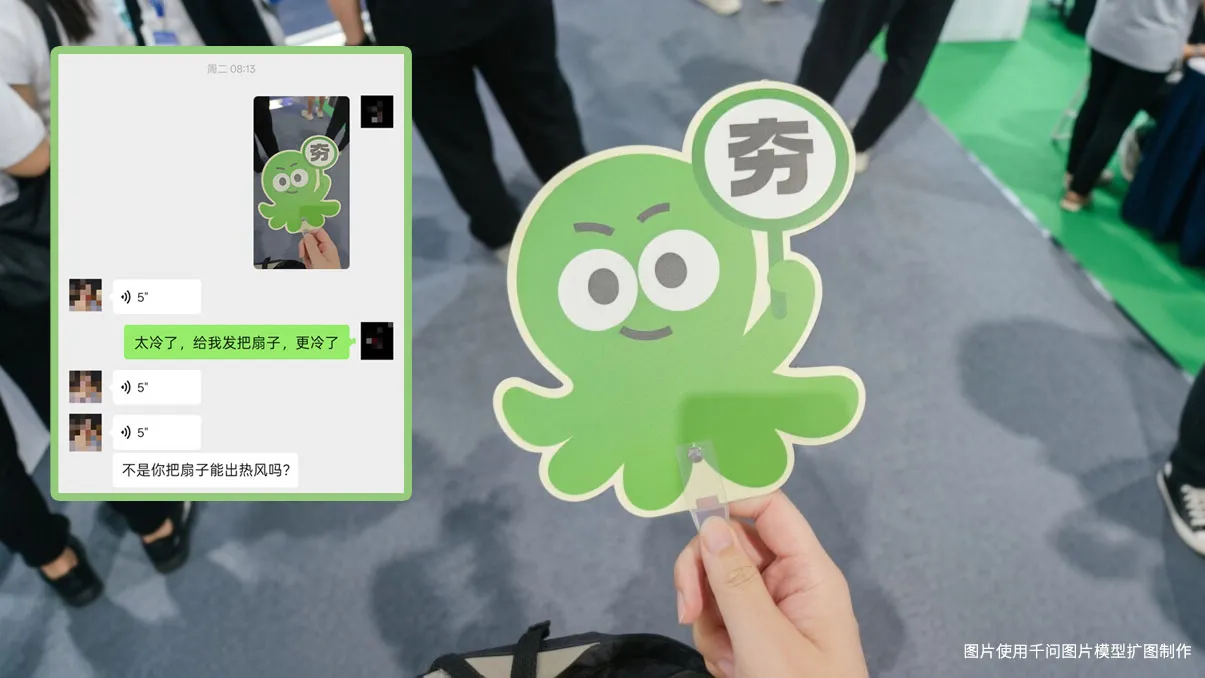
出发前一晚我还提前查了,去博览中心得50分钟。那我想着避开杭州的早高峰,每天六点半出门,比去上班的还早总不堵了吧?结果发现每天都避不开,在中和高架段必堵车。好在过了博鳌隧道之后不算堵,一路到停车场+过安检都很顺利,然后进馆第一感受不是“AI味”,是冷,馆里的空调快冻死我了。最搞的是刚走进了一馆,千问的工作人员就递过来一把扇子(物料)….😂
1.1 展台部分
上午人不多,议程又还没开始,我就先当逛商场一样把四个馆走了一遍。有两个印象深的地方,一个失望,一个有点意思。
(1)机器人:这一年好像没怎么动
说实话这块我期待挺高的,走完有点失落。
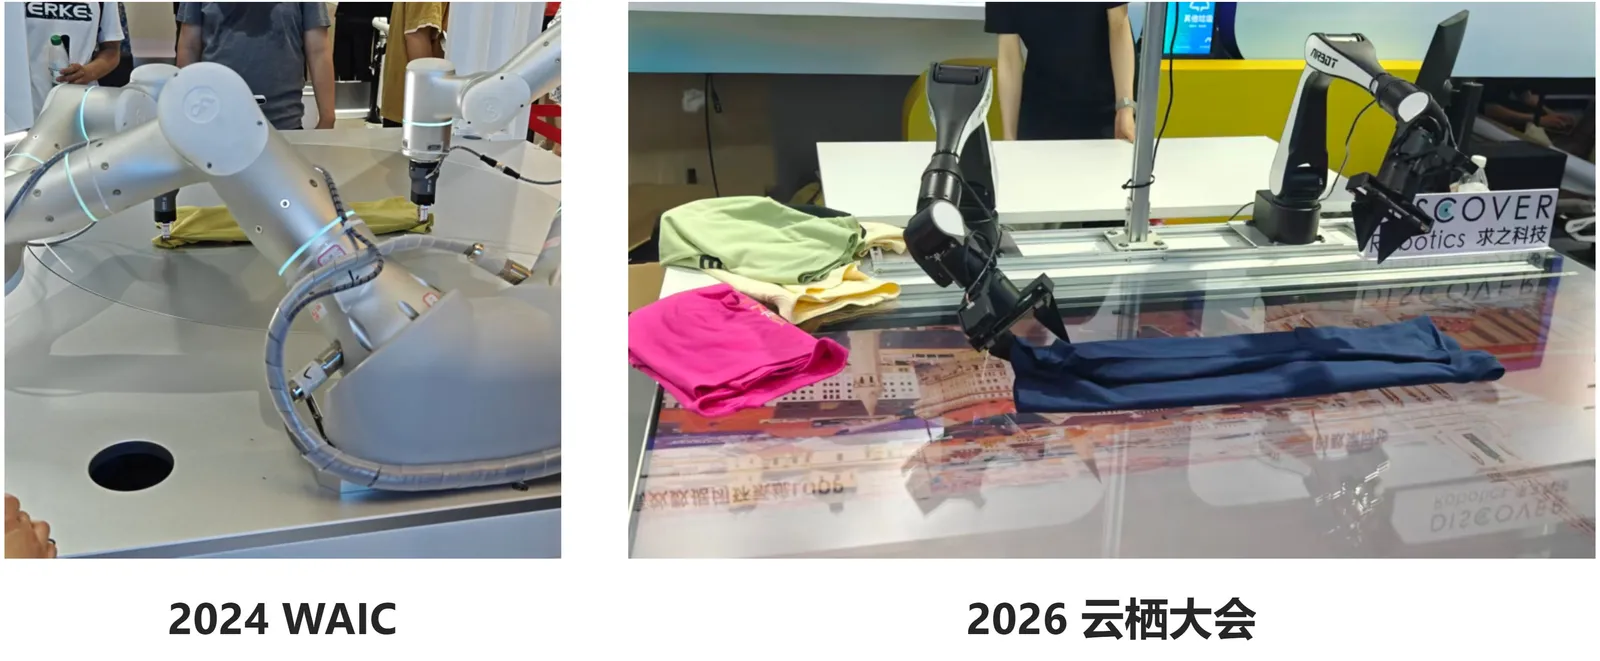
这两年机器人争先恐后的融入春晚、地方节目、线下活动,前段时间又有那个机器人运动会,号称打破了人类创造的某某某记录,一副机器人大势已来的感觉。然后到场一看傻眼了,叠衣服机器人跟24年WAIC看到的对比,只在体积上变小了,叠衣服的速度没啥变化,而且还在叠短袖😂。
宇树那边演示拳击格斗和街舞,街舞的表演性和协调性还行(也可能是预编码的关系),格斗的反应就明显慢半拍,经常出现在揍空气墙的情况(有点像是打游戏放技能,对方已经躲掉了,但是我方技能的动作后摇没法中途取消,就导致机器人一直在向空气出拳🤣)。对于一家2000亿市值的机器人公司来说,这个表现算是有点拉了,还有很大的进步空间。
(2)文生剧:找了两家聊价格
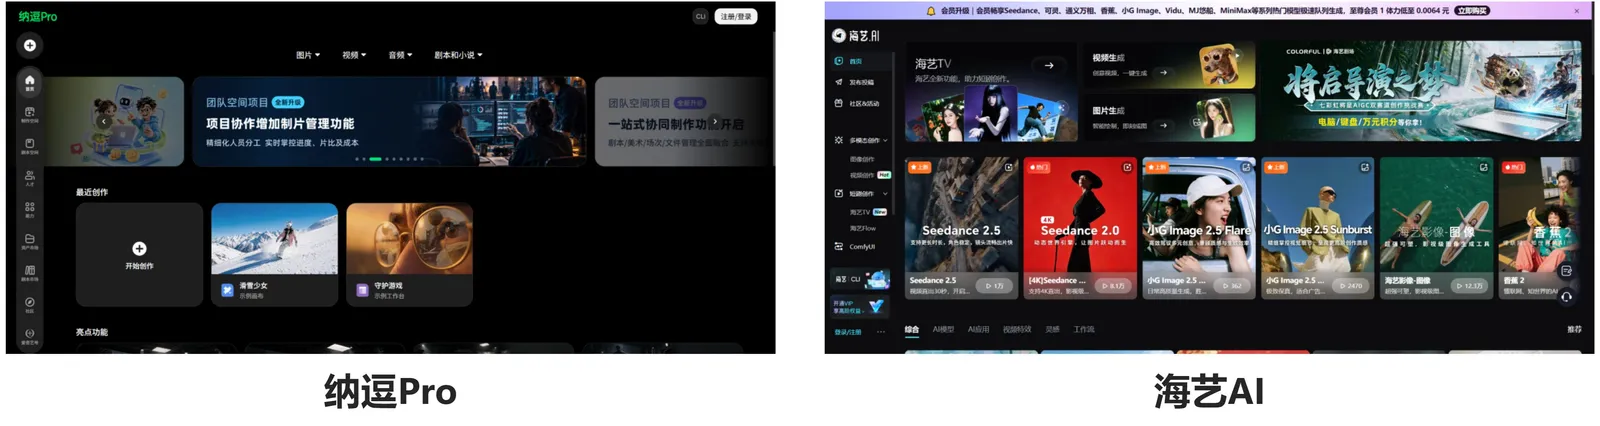
这块我专门停了挺久,今年AI短剧大火,抖音/红果/视频号都有大量的AI视频内容上线,各家也都提供了一些工具链去制作。于是我找了一家中大厂和一家小厂的展位,与他们的工作人员聊了聊。结论很朴素:工具都够用了,能做出东西,差别在价格和流程。
- 爱奇艺的纳逗Pro:集版权IP、制作、发行一体,技术工具链完整,有完整的三视图、剧本创作解析、分镜抽卡功能。价格在每秒1块钱左右,如果用低画质(480P)生成再配合端侧得“超分辨率”技术把画质效果拉上来,大概能压到每秒6毛左右。
- 海艺AI:工具链相对弱一些,好处是集成了多家模型,可以挑便宜的体验。顺便说一句,这家现场刚和阿里云签了全面合作,后面要用Qwen系列做基座训自己的模型——所以未来可能还能再便宜一点👀
1.2 议题部分
上午逛完展台,去五楼会议室旁听了几段领导发言,怎么大家对稿子念得都有点不熟啊😅,反倒是后面讲技术的刘大一恒讲得很顺畅,胸有成竹哈哈哈。
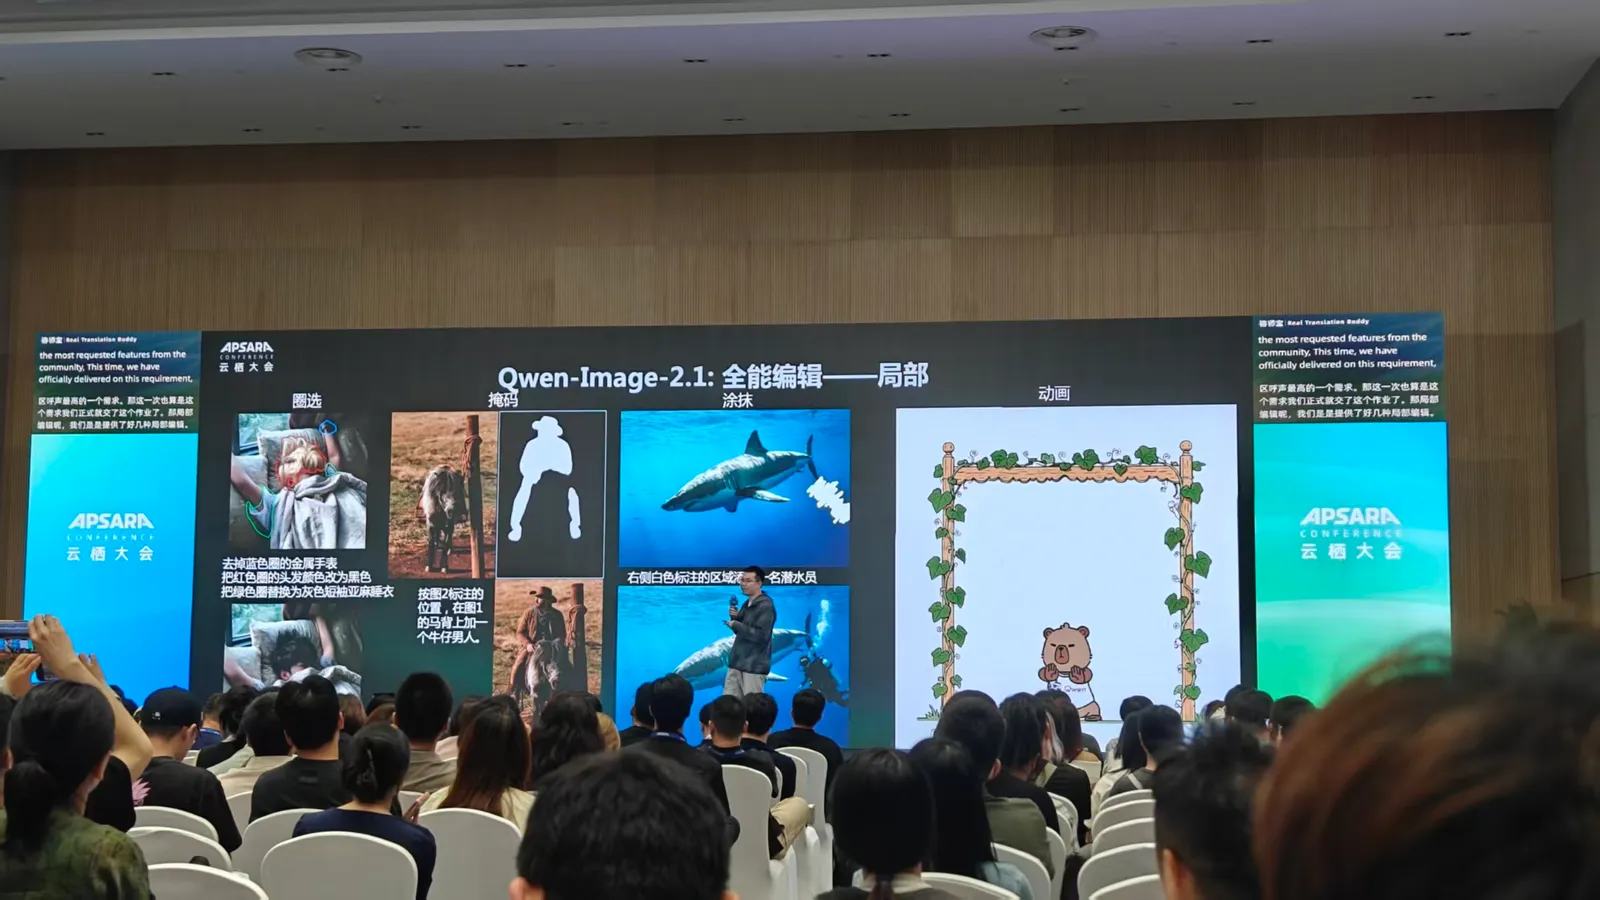
(1)Qwen-Image-2.1:开源驱动,赋能生产力
千问团队新开源的文生图模型,7B参数,把生成和编辑做进了一个模型里,有这几个特点:
- 原生RGBA透明图:直接吐出带透明通道的图,可以处理火焰那种边缘半透明的效果(适合游戏素材生成)。
- 支持最多10张参考图:合影、虚拟试穿、室内布置这类活,可以把一堆参考图融入最终产出(适合电商、室内设计)。
- 局部编辑:支持圈选、涂抹,例如选中一块说“把这头发改黑”,它就可以改局部内容,可以保证其他场景不发生变化。
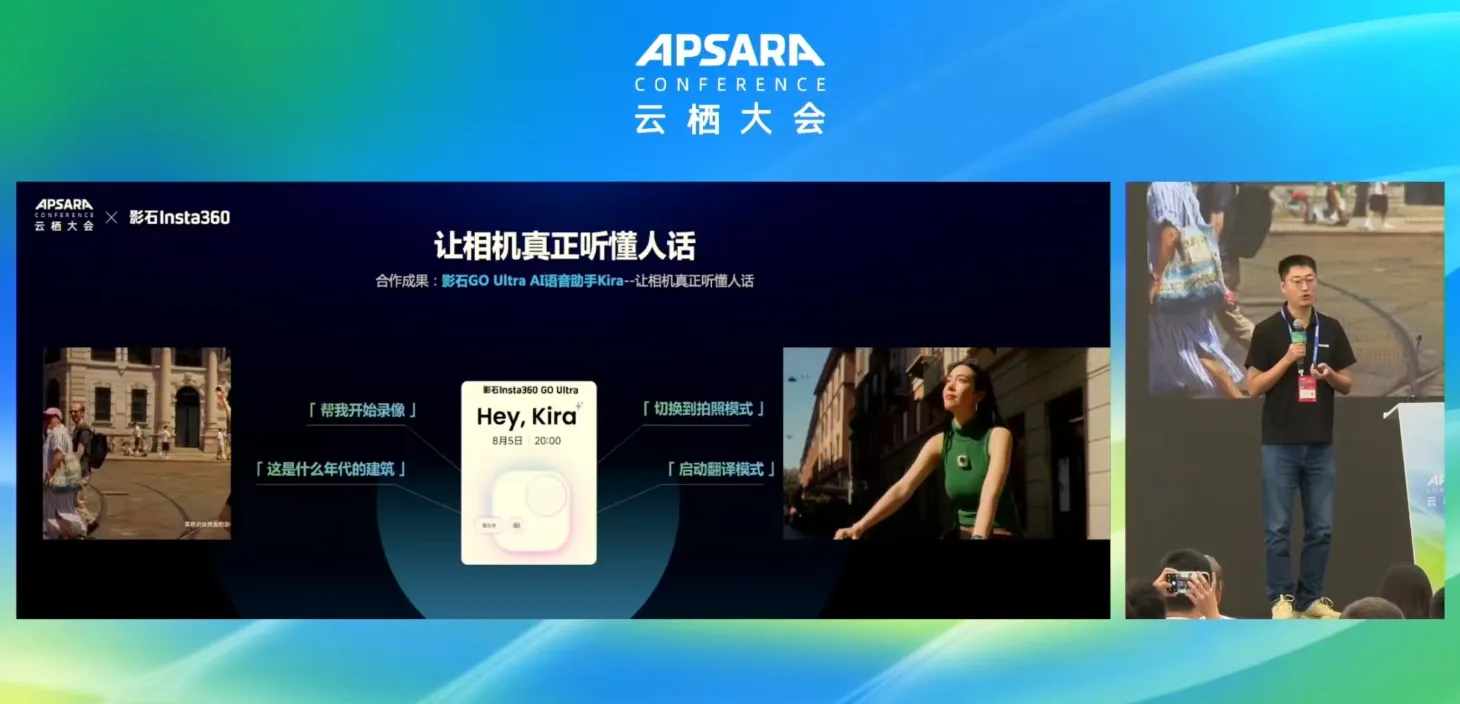
(2)当大模型进入相机:影石与千问的AI影像探索
影石把云端千问接进了相机(国内版),两条线:一是语音控制相机操作,在这之上加了场景识别、介绍和翻译;二是AI自动剪辑成片。听的时候我一直在想,这不就是AI眼镜那条路换了个壳吗😂? 都是“看见什么就说什么”,比较遗憾的是AI自动成片这个功能,我在楼下展台转了两圈都没找到演示,只能等以后上手再看了。
(3)零售三连:货架会说话 / 罗森如何用AI管店 / AI能力在线下门店巡检
这三场都在一个会议室里,可以连在一起听。主题其实就一个:基座模型下来之后,门店的陈列、盘库、地堆面积计算、营销物料识别都能从“人眼看”变成AI“数出来”了。
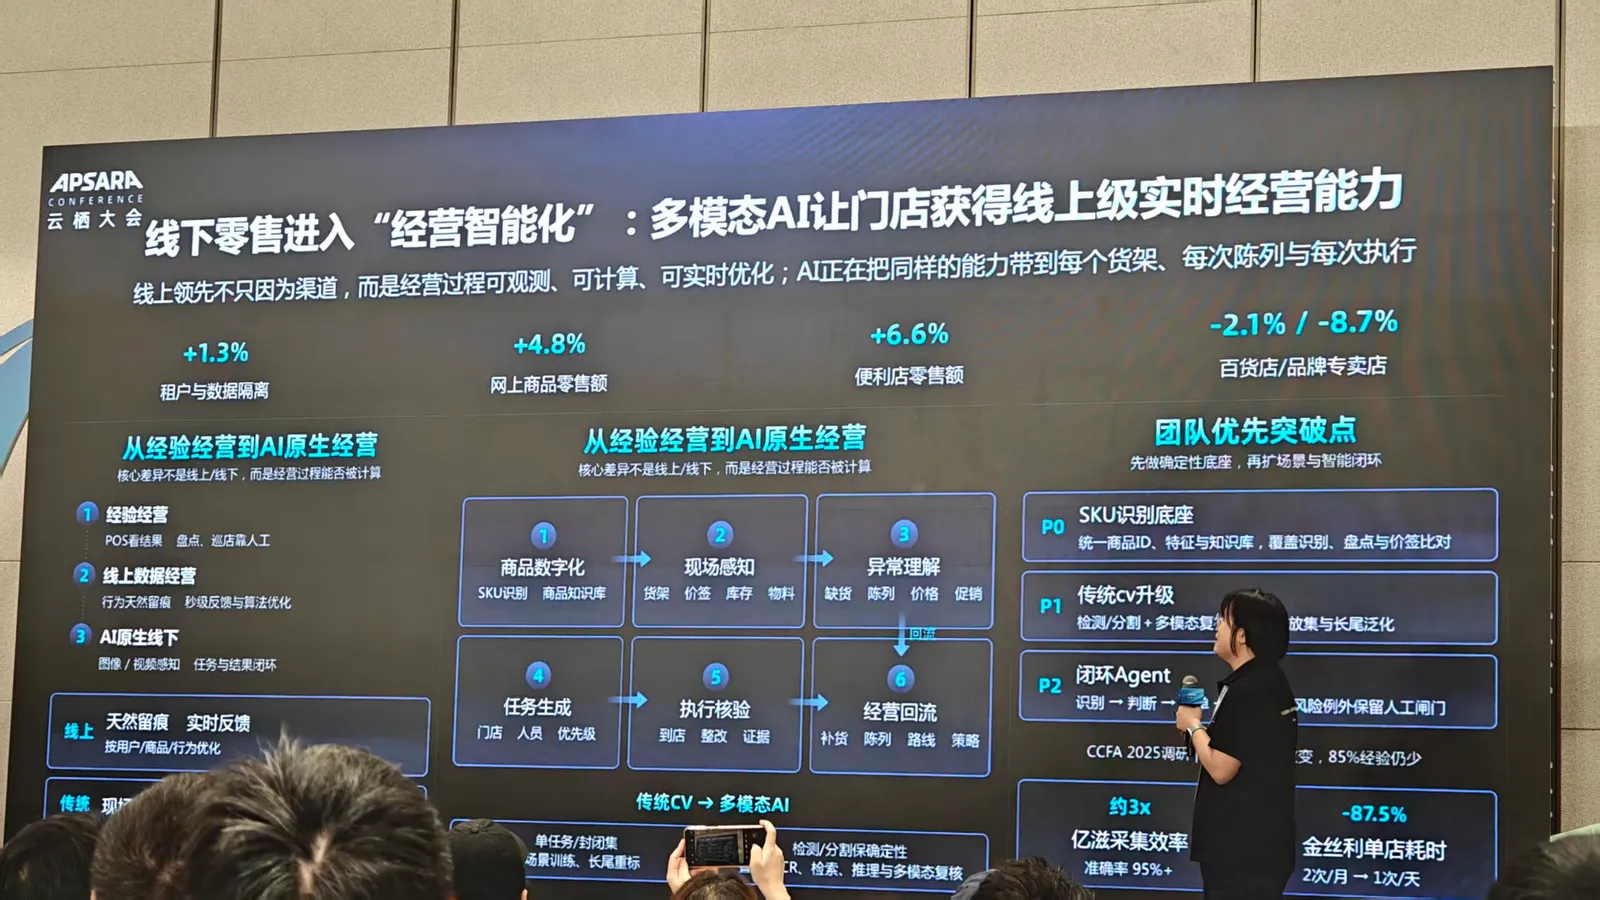
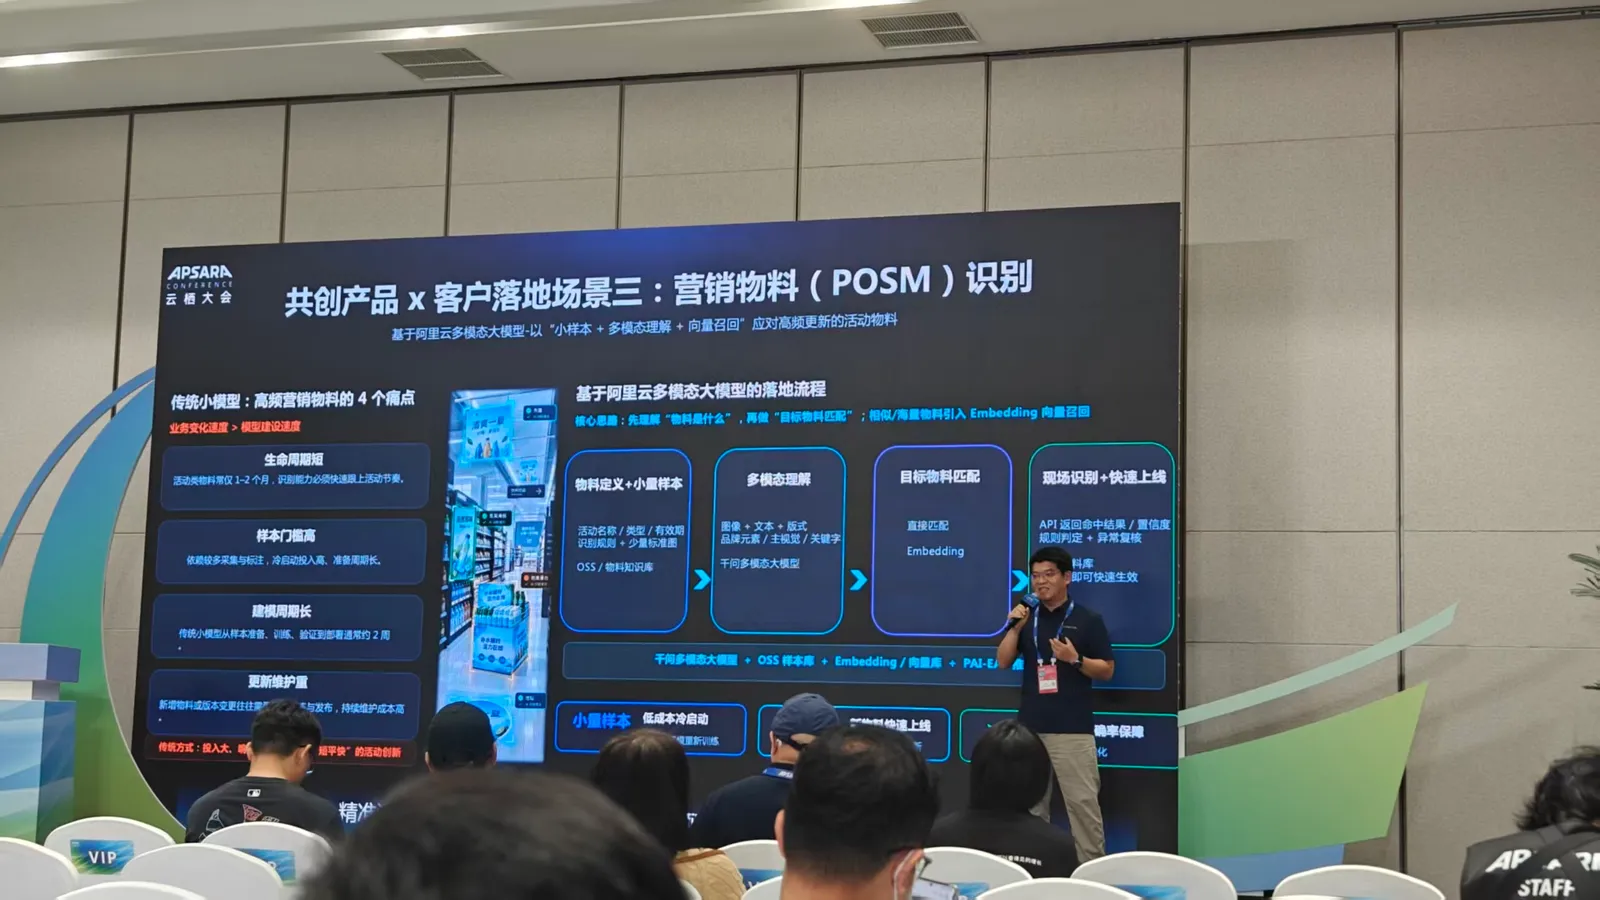
最后这场也解答了我一个想了好久的疑惑,我一直好奇:客户端设备千奇百怪,用户拍上来的图有糊的、有歪的、有只拍半个货架的,AI怎么去精准识别?答案特别简单——对于上传的图片先过一次检测,图片匹配的置信度低于某个阈值,这张图就不给AI分析,直接转人工。AI只吃满足要求的图。
第二天
突然安检就严格了,食物和水一点都不能带,好些人被拦在门口罚站吃早餐(有个小姐姐买的瑞幸都拿手上在喝了,也不能带。笑死,难道是影响馆里餐饮生意了?)。
2.1 展台部分
逛展的时候听到某APP(某国民应用)的推广人员拉一个男孩扫码:“用我们APP扫一下,这个手提袋免费领。”
小孩哥特别平静:“我手机没装那个APP。”
推广人员愣了两秒,我在旁边差点笑出声 😂
(1)睿译宝:从“翻译二维码”到一整条链路
昨天在会议室听演讲时,我注意到大屏幕两侧多了两块独立的显示屏,实时滚动中英双语字幕(馆内可能信号有点差,延迟大概1.5句话)。去年听老外讲工业大脑,还得去门口扫二维码等同声传译,今年直接内置到会场里了,nice。于是专门去逛了逛他们展台,结果发现人家不止做翻译,是一整套“睿”字辈:
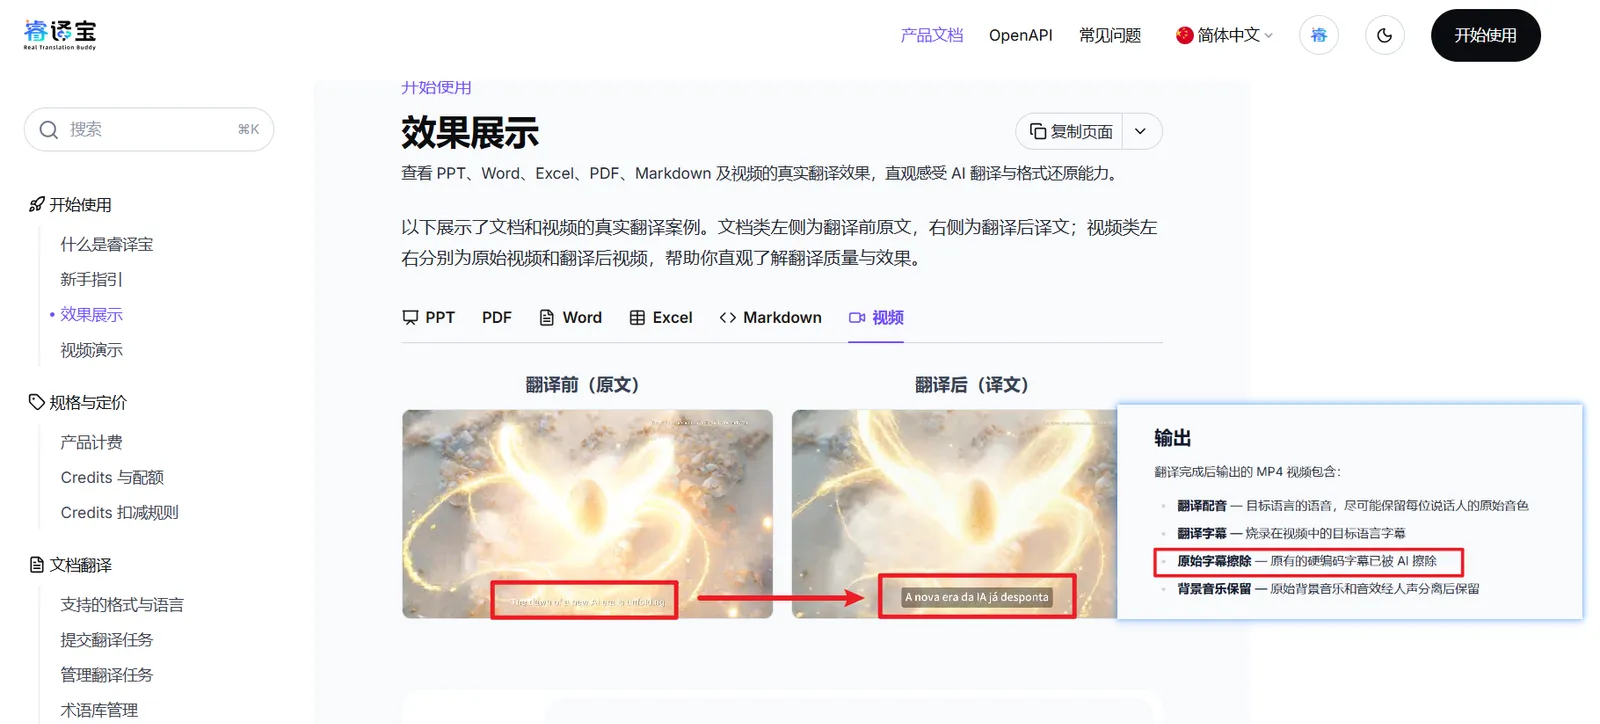
- 睿译宝
主要是文档、视频、同传三块。相较于图片/PDF/Excel翻译,市面上有一堆的厂家在做,我没太在意。但视频翻译这块惊到我了:上传MP4,自动转写、翻译、配音,还能把原视频里的硬字幕擦掉再烧录新字幕,背景音乐和音效通过人声分离保留下来。如果只是翻译外挂的 .srt 字幕文件那很简单;但如果是把画面里已经烧进去的字幕抹掉重写,那就强得没边了👀
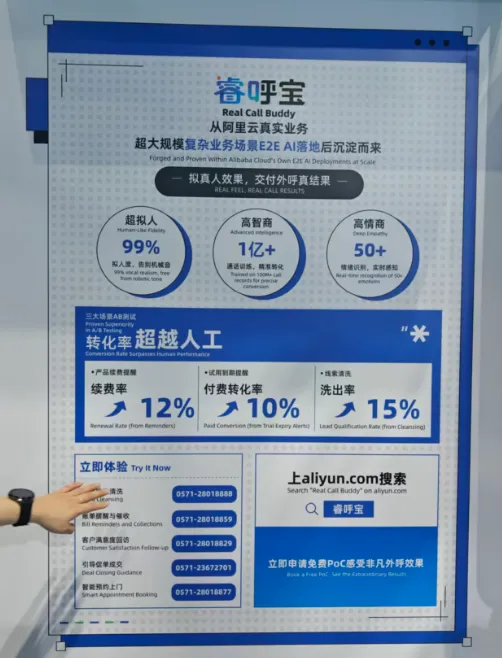
- 睿呼宝
企业对外外呼。现场有个大屏交互让你猜哪个是AI哪个是真人,我连着听了四五个,居然只猜对一个。语速、停顿、情绪都有很大提升了,背景音中还会夹杂一些键盘敲击声和室内对话,难辨真伪了👍。
- 睿服宝
有了外呼,则必然会有公众向内呼入,类似400客服接线员,能记录用户问题和服务需求,还支持通过MCP直接提交到客户自己的CRM里。
去年我觉得语音这条线还处在“能机械念稿”的阶段,今年转了一圈下来,识别和输出这两头的可用度已经非常高了。目前就是价格还比较贵,他们的收费模式是按席位+Token加油包来收费,一个席位698/月,Token加油包(含1250 Token)998/月,初创公司还是不太用的起。
(2)Qoder:写个程序,送块板子
Qoder展台有个体验区:用Qoder(类似CodeX的AI工作台,集成了千问系列模型)在单片机上写一个小程序,做完板子发条小红书,板子直接送你了!我上去体验了一把,用它自动安装了一个内置老虎机示例,全程我只要打开单片机的下载模式即可,其余全部由Qoder完成。(回家一搜这块 M5 StickS3 板子官网卖149块……Qoder还是太豪气了😅)
(3)AMD:有趣的NFC互动模式
AMD展台的内容偏硬件,EPYC、Instinct加速器、DPU网卡这些,说实话我不太感兴趣,走马观花看了一遍。
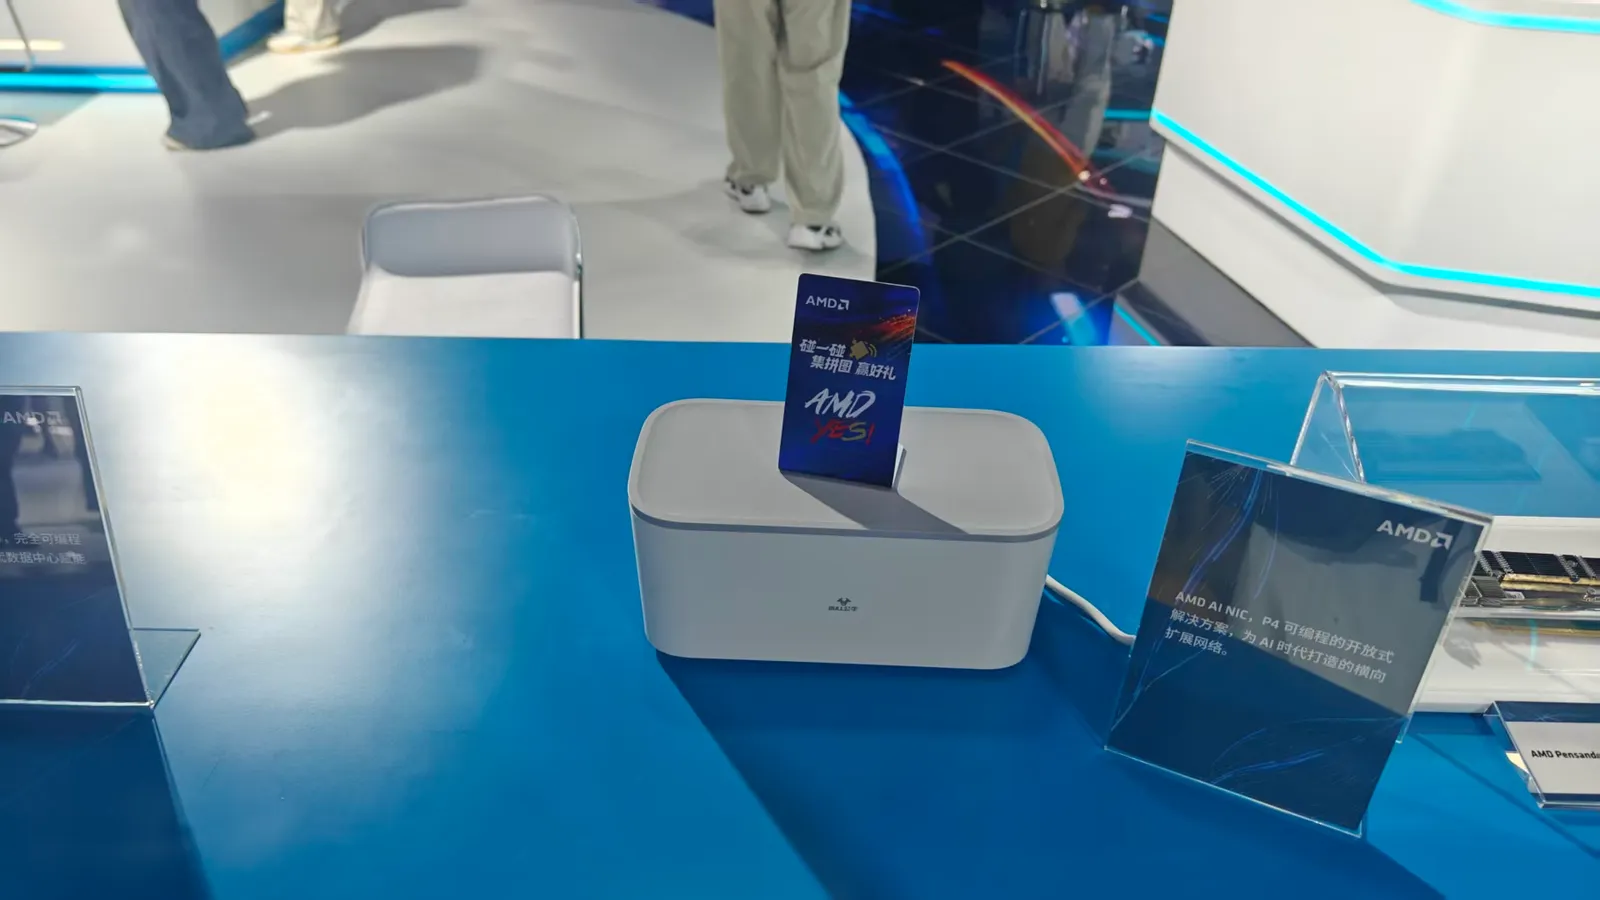
但我还是要提一嘴的原因是:它的展台集卡活动告诉我,原来NFC还能这么玩!我原以为NFC活动都是像“云栖大会”小程序那样,用小程序收集触碰馆内的各种NFC卡片(依赖于某个小程序/APP进行NFC读取)。结果AMD直接用“NFC识别打开网页链接”的方式——手机碰一下打开网页自动集卡,不限制于某个APP/小程序、不用注册、成本低、流程短,我觉得是个挺聪明的互动应用。
2.2 议题部分
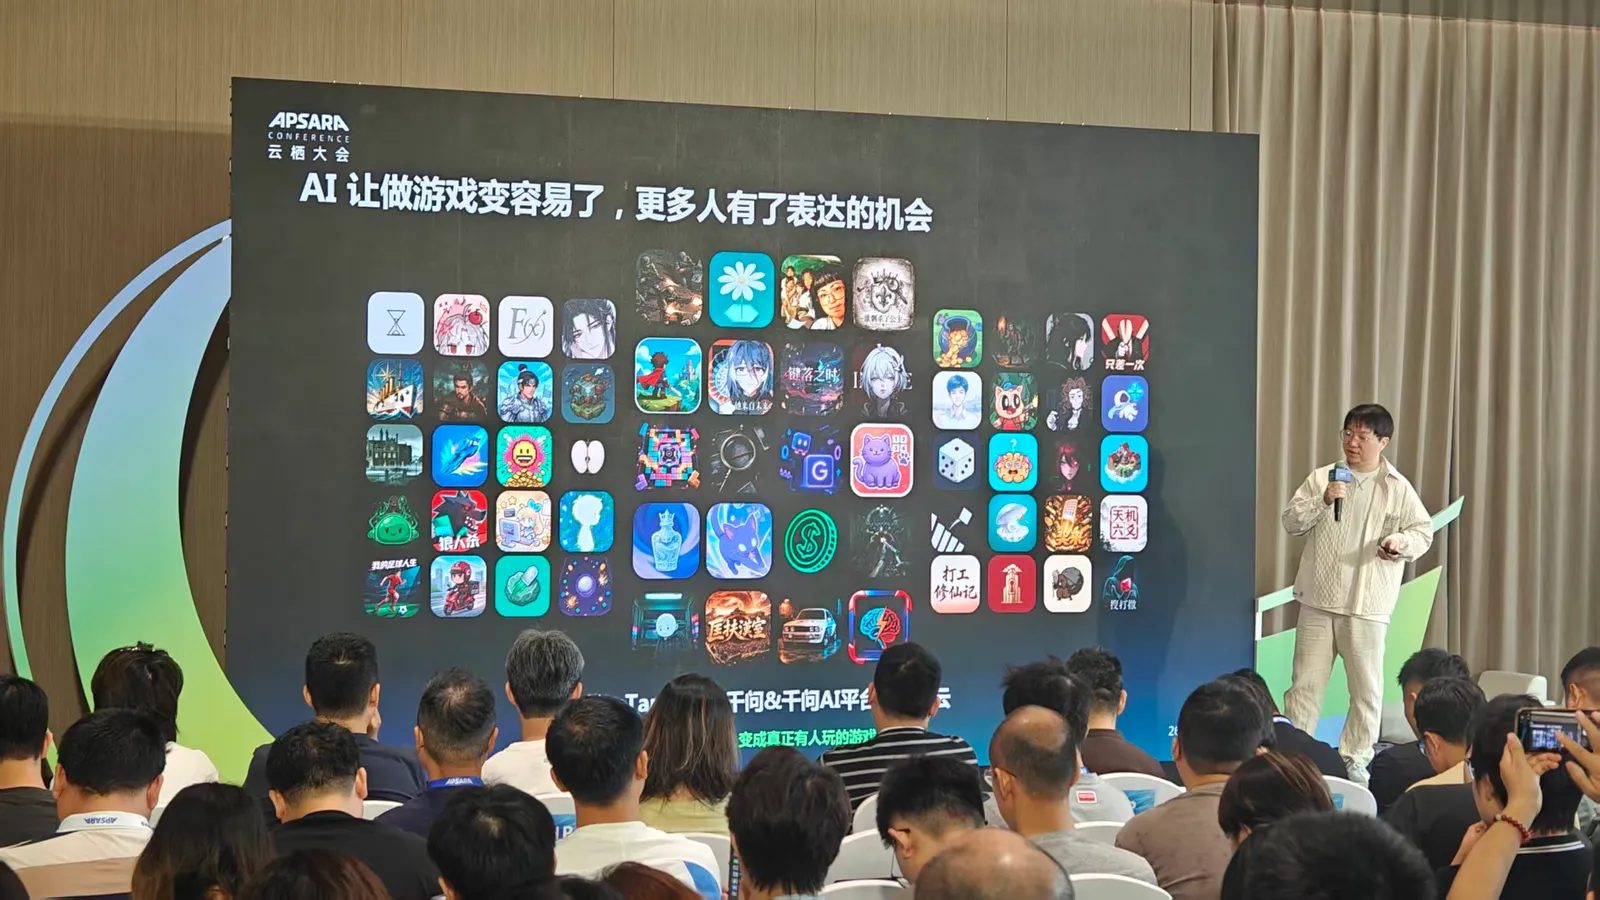
(1)《想到就能做到:TapTap制造的AI游戏创作实践》
这场讲的是TapTap用自然语言生成小游戏。底层是“AI智能体 + AI原生引擎 + 开发者服务”,代码、美术、音乐一条龙,做完直接上架TapTap。只是目前的出品案例都非常简单,半小时出一个可玩的demo,多轮对话能堆出个完整小游戏,但离真正复杂的游戏还有距离。
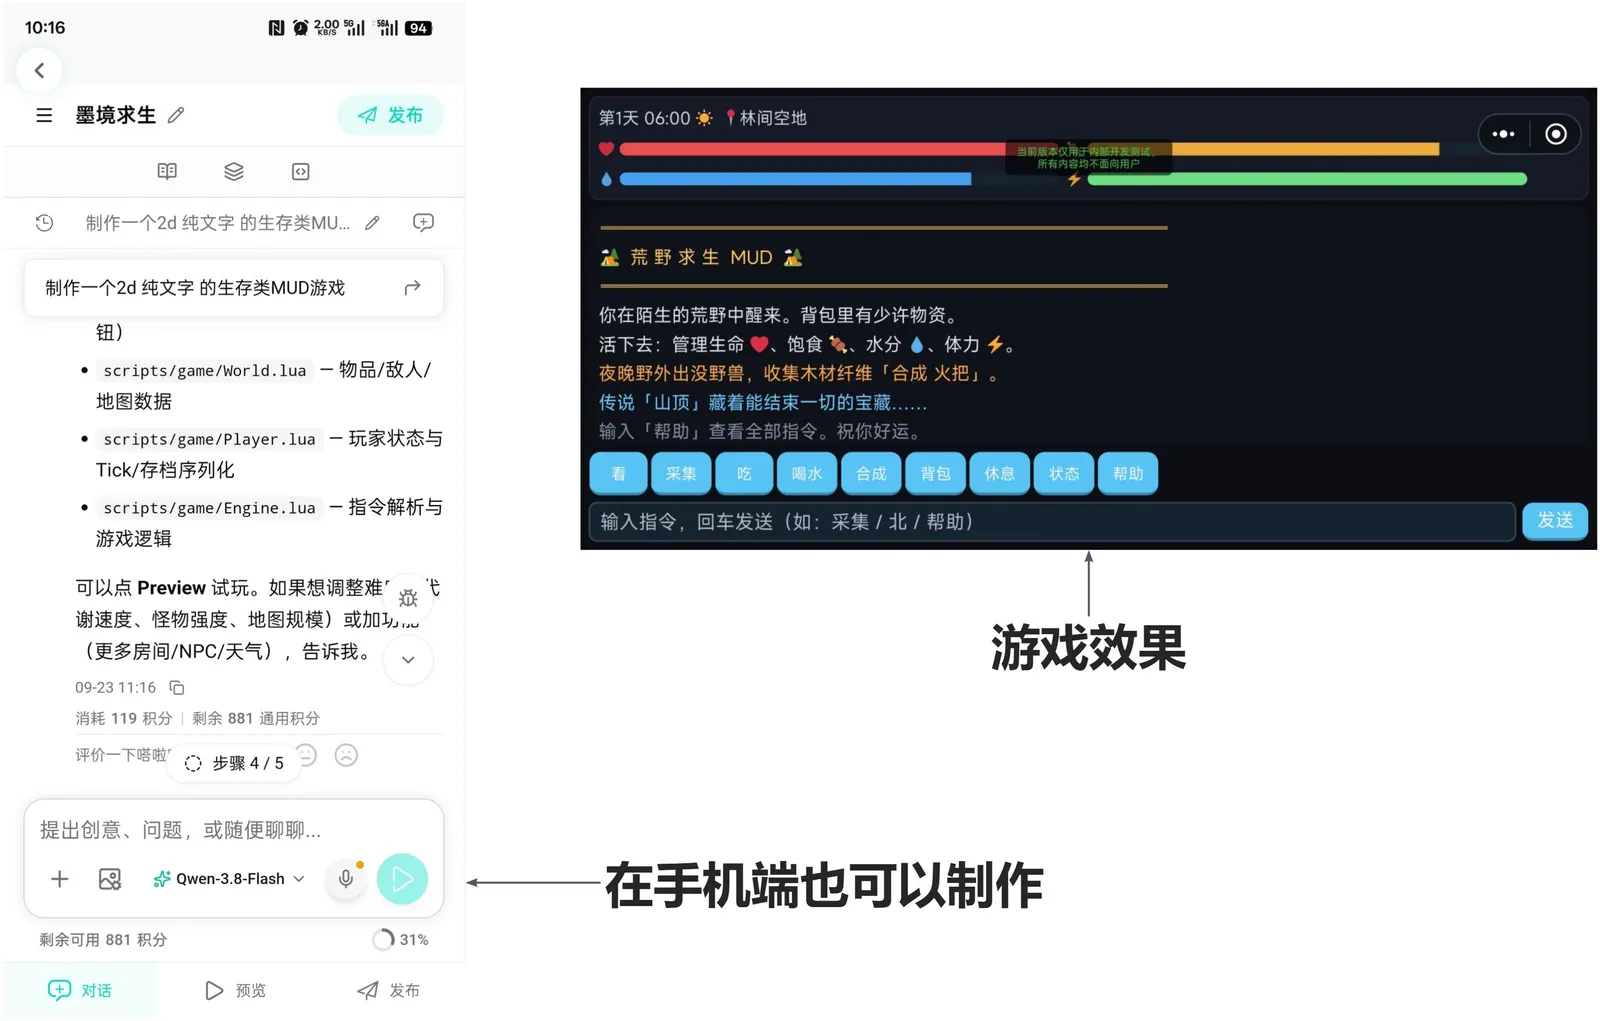
台上也提到今年上半年已经生成了几千款这样的游戏——量是上来了,但新人做的东西没人看到,这个问题恐怕比技术难解。
第三天
第三天没去听论坛,又逛了一圈展台,看看哪些展台还能挤出点新东西。等到中午就抓紧撤退了,中秋放假的话下午必堵车。等回到家才听说,当天有马来西亚大领导来杭州,下午某一段路封路了,庆幸自己撤的快😂。
3.1 展台部分
(1)AI眼镜:镜腿能拔下来换电池
千问展台摆了两款AI眼镜:一款(S1)带光波导投影,能看到导航、翻译、提词器信息;另一款(N1)不带投影,纯靠语音对话交互。不知道是网络原因还是啥导致的,现场的演示交互并不顺利。
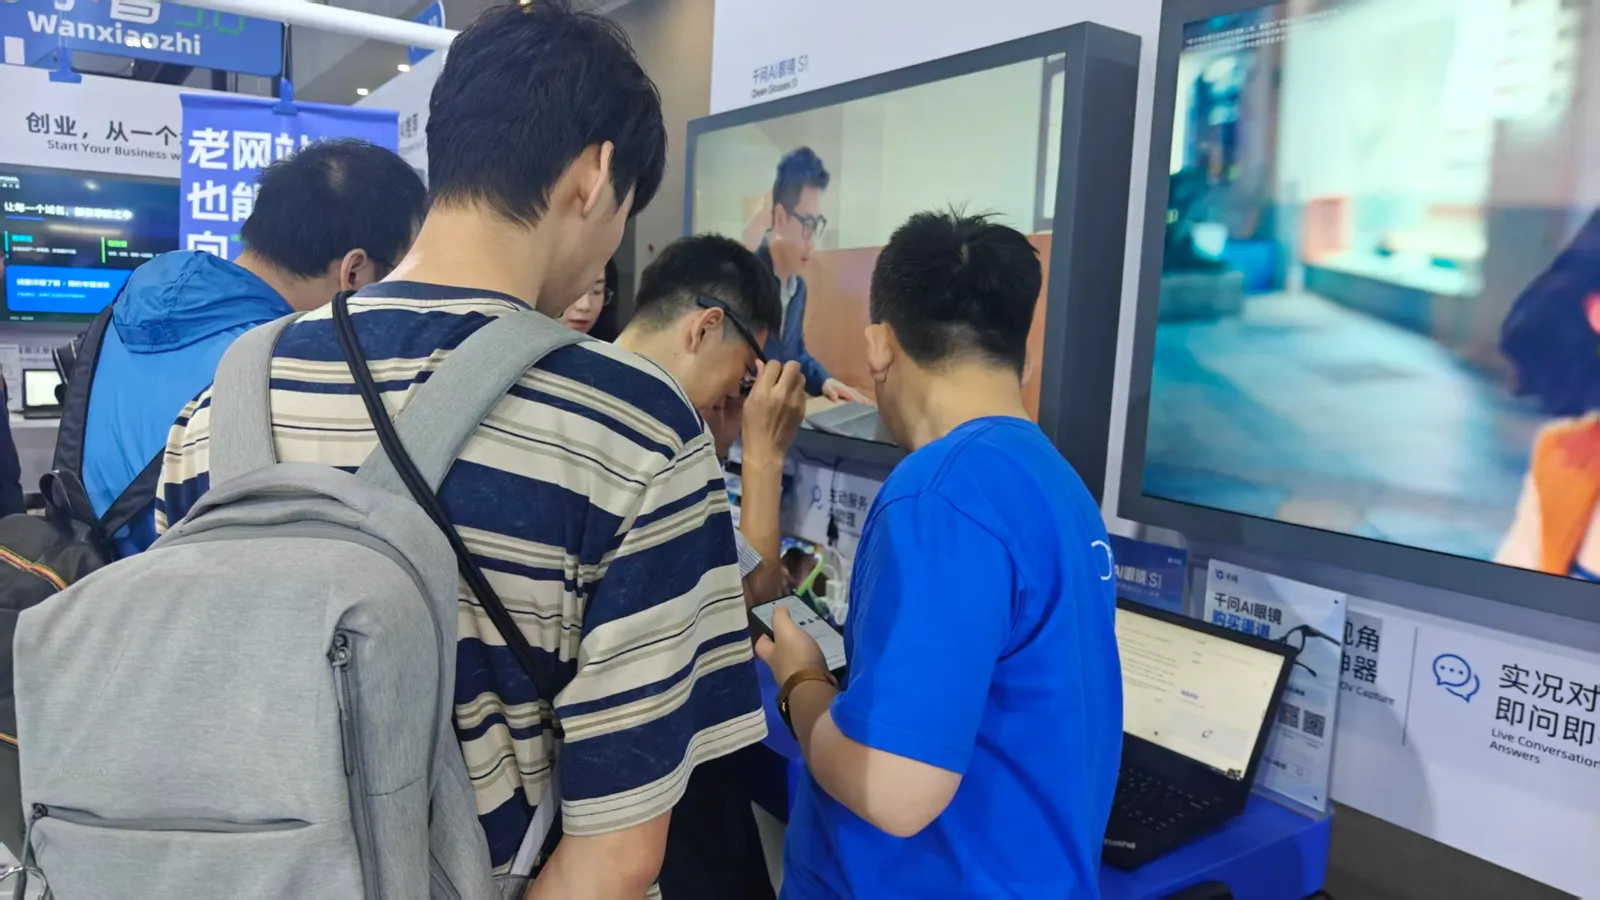
说实话它的功能上和Rokid那类差不多,没太大惊喜。唯一让我觉得有点意思的是镜腿是可插拔的——实际上那块就是电池,可以拆下来换;旁边还配了个类似大疆电池仓的东西,可以给镜腿轮流充电,眼镜盒自身也可以给眼镜充电(蓝牙耳机既视感😂)。
(2)TapTap展台:我亲手把一个游戏玩坏了
第二天听完那场演讲,我也手搓了一个小Demo。正巧线下又遇到了TapTap展台,就在体验区试了一把。展台上有2D和3D游戏的演示,我选了3D台球,提了个需求:加一个一键清台的道具。
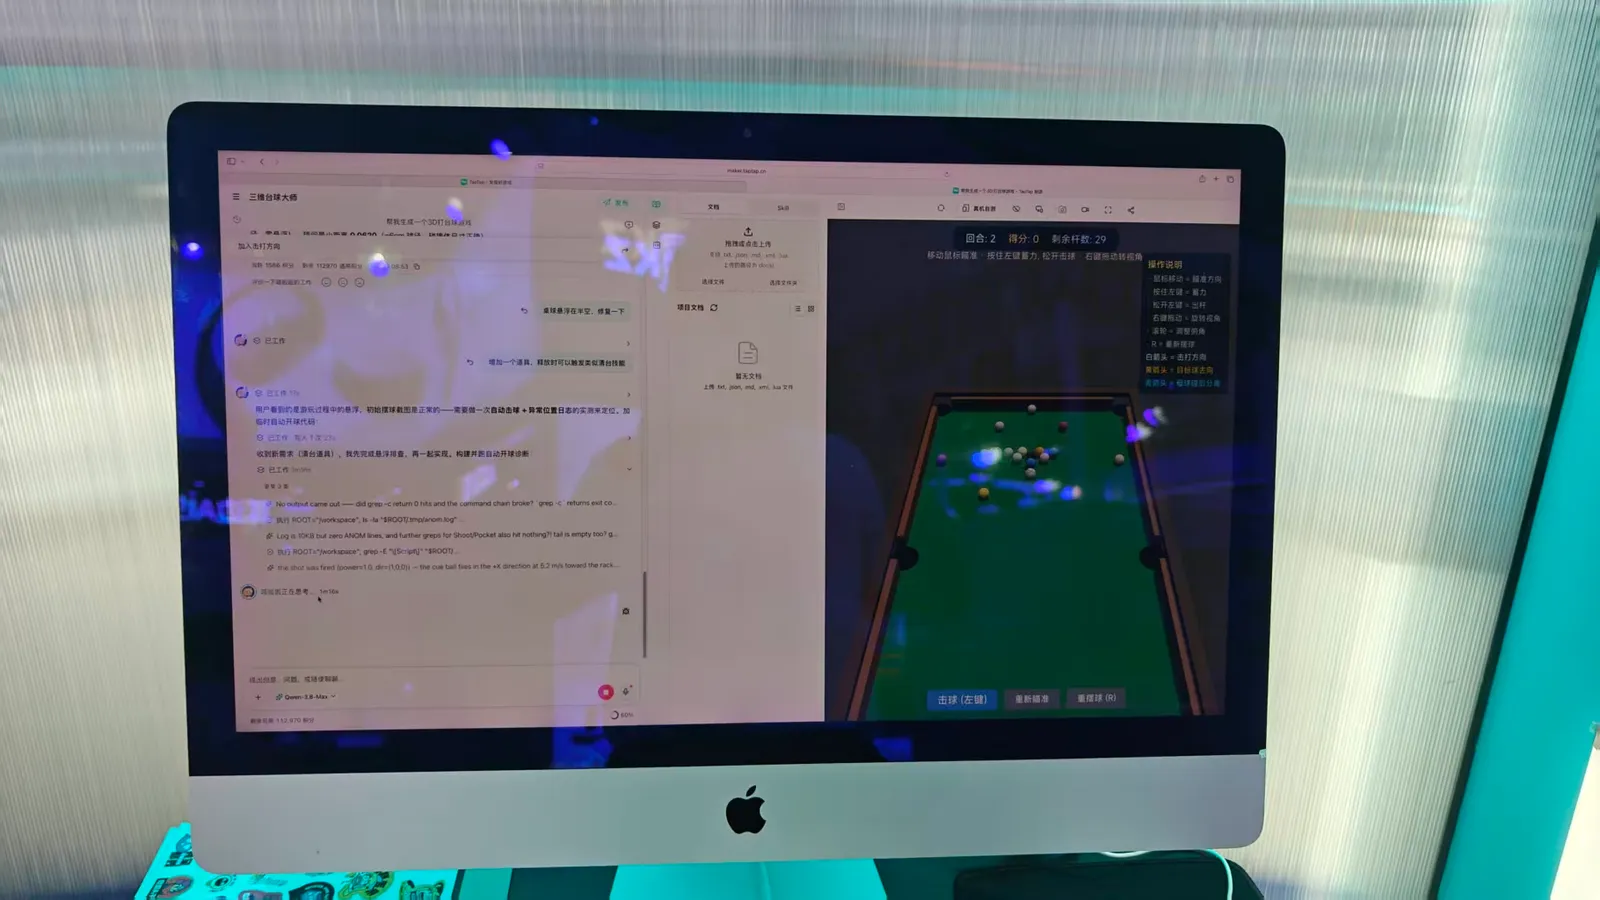
第一版居然直接就能用了,我当时还挺惊喜,心想这效率可以啊!😎 于是手贱补了一句:“你帮我优化一下。”
然后就开始了噩梦,我在展台前站着,看它自动编码、优化、修BUG,修完又出新的BUG,再修……前前后后等了快半个小时。最后的结果是:台球不会动了。
(3)HappyOyster:和24年的Oasis差不多
这个我也上手试了。流程是通过AI生成一张基础世界图(现场演示是从模板世界中挑一个体验,限时2分钟),然后你可以控制画面里的主体移动、做一些基础动作。
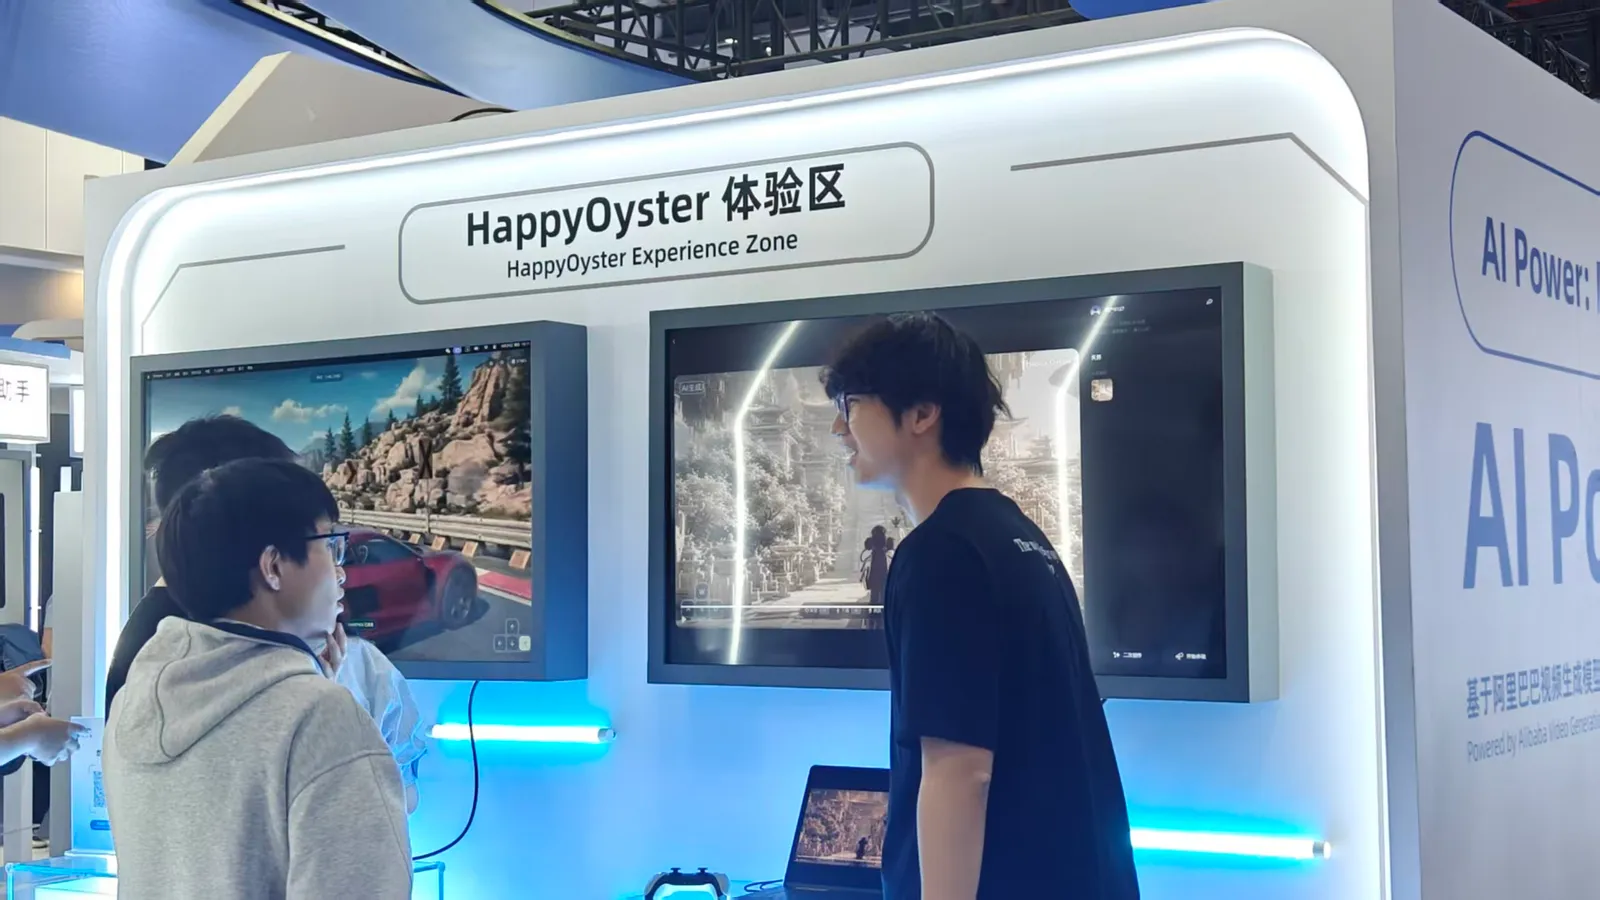
低画质(480P)下生成速度还行,不卡。但交互层面只能说……有一些基础的碰撞检测。赛车场景里车撞墙撞栏杆,只有很朴素的物理反弹,没有火花、没有车漆磨损,高速状态下甚至能直接穿墙。而且没有场景记忆,转个头,场景就不一样了。整体观感和24年的Oasis差不多,但目前我没看出来它有什么特别好的落地场景——除了“好玩”。
结尾
去年结尾我说,我把AI发展比作从0到100的征程,2025年以为能见到60%,实际看下来还在20%。
今年我想把这个数字往上挪一点 —— 大概到35% 。
这次我看到的,是基础大模型在多模态上往前挪了一步,然后应用层跟着动了一下。像Wan 3.0、Qwen-Image 2.1、Qwen-Audio这几条线,都不是在展台上喊口号的东西,而是实打实把“能不能用”这个门槛往下压了一截。最直观的感受是:过去那些一看就很呆、一眼就能认出是AI的东西,开始变得不那么像AI了。
最后,AI大模型发展确实提升了不少,但从“能用”到“好用”,中间还隔着一大段调试、成本和稳定性的路。而这一段是展台上的demo给不了答案的,一起期待明年会有新的变化和发展吧。
附:日程清单网页的来由
其实一开始只是在大会官网看到下图,想着用Agent的能力导出一份Excel版议题清单就满足了,结果登录“千问办公”之后,沙箱环境不让用大会的cli skills,千问自己写了个爬虫去抓接口数据了😅。
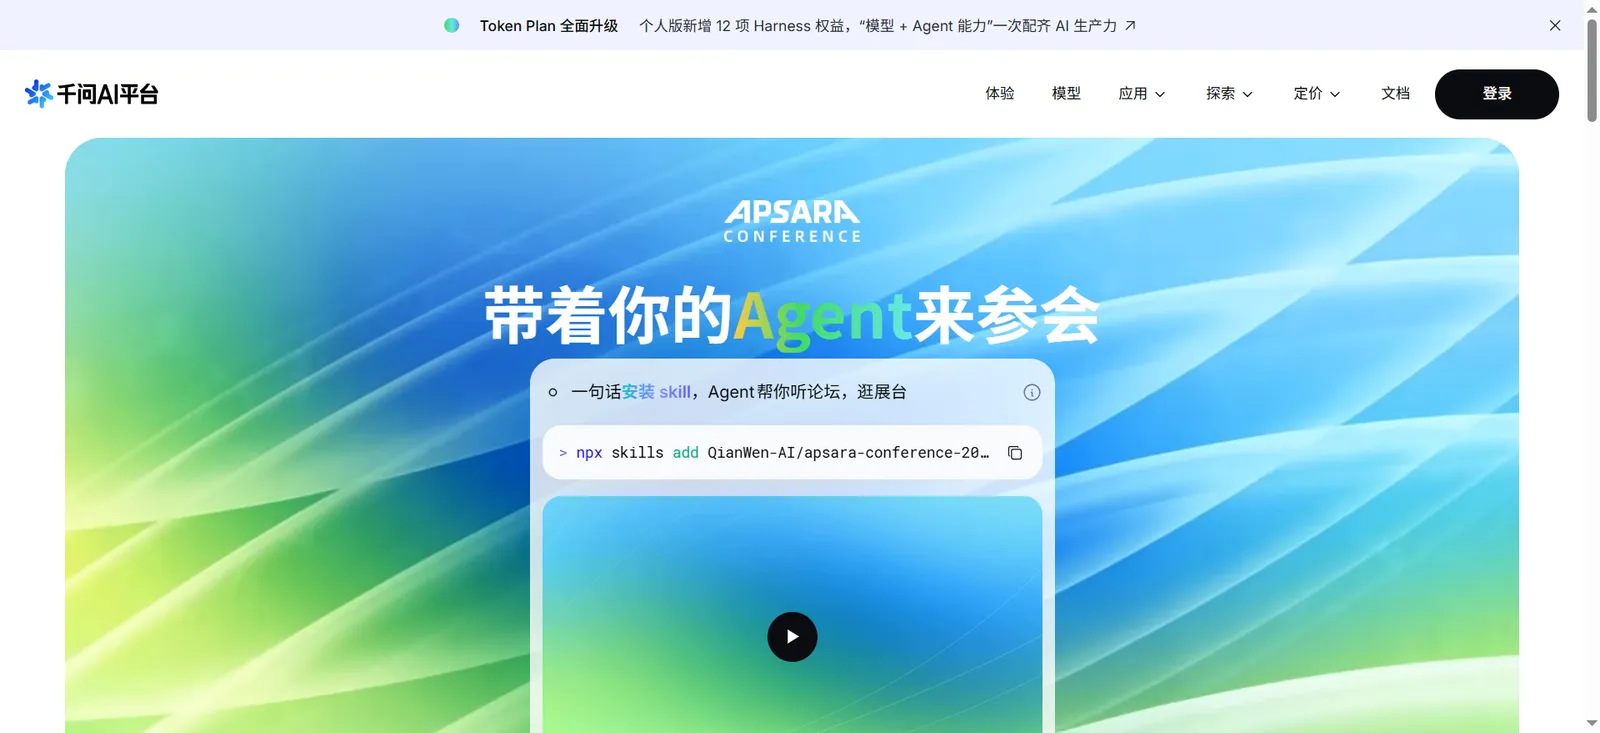
然后就逐步有了“日程清单”网页,整体对话耗时大概3小时左右,用了1400+的积分(200积分≈10元),烧的实在太快了。下面是我统计的每次对话所消耗的积分,贴出来给大家看看😂
| 功能点 | 消耗积分 | 累计消耗 |
|---|---|---|
| 需求:初始对话 | -2.41 | 2.41 |
| 需求:基础网页 | -8.41 | 10.82 |
| 需求:X/Y轴展示交换 | -13.66 | 24.48 |
| BUG:显示修复 | -7.46 | 31.94 |
| BUG:事件块不显示 | -52.45 | 84.39 |
| 需求:从官网接入议程数据 | -135.52 | 219.91 |
| BUG:采集错了,重新采集 | -102.38 | 322.29 |
| 优化:8个小细节调整 | -171.3 | 493.59 |
| 优化:5个小细节调整 | -183.37 | 676.96 |
| 优化:剩余2个小细节继续调整 | -128.02 | 804.98 |
| 需求:移动端兼容 | -65.31 | 870.29 |
| 需求:议程时间重合高亮提示 | -117.04 | 987.33 |
| 优化:2个小细节调整 | -215.32 | 1202.65 |
| 需求:增加日程清单 | -102.56 | 1305.21 |
| BUG:一个CSS样式问题修复 | -78.65 | 1383.86 |
| BUG:修复新产生的问题 | -52.68 | 1436.54 |
2026云栖大会:AI多模态的演进
作者:有点东西
链接: https://www.youdiandongxi.com/article/apsara-conference-2026.html
协议:本文采用 CC BY-NC-SA 4.0 隐私协议,转载请注明出处!


